アラート一次調査の自動化——自前のAIエージェントに障害の初動を任せるまで
「AI、何使ってるんですか?」
「金重さんって、AIは何を使ってるんですか。Claude Codeですか、ChatGPTですか、Geminiですか」
最近、よく聞かれる。これに正直に答えるのは、少し難しい。私はそうした汎用のチャットAIを、日常のサーバー障害対応には使っていない。サーバーの障害対応は、自前のAIエージェントにやらせている。だから「どれですか」と聞かれると、答えが少しずれる。
もちろん、汎用のチャットAIをそのまま使うのが最短な場面は多い。ただ、監視しているホストが夜中にアラートを上げたとき、チャットを開いてログを貼り、状況を言葉で説明し、対象ホストのディスク内訳を別のターミナルで取って、また貼る——という手順を毎回なぞるのは、運用としては重い。汎用AIは賢いが、私の監視基盤も、私のサーバー構成も知らない。知らない相手に、毎回ゼロから状況を説明し直すことになる。
そこで、自分の環境を前提に動く小さなSREエージェントを自作した。アラートが鳴ったら自動で一次調査を回し、結果を普段使っているチャットに流し、そのまま会話で詰めて承認できるところまでを組んだ。以下は、実際に配備して動いている構成の記録である。
全体の流れ
実際に動いている経路を図にすると、次のようになる。
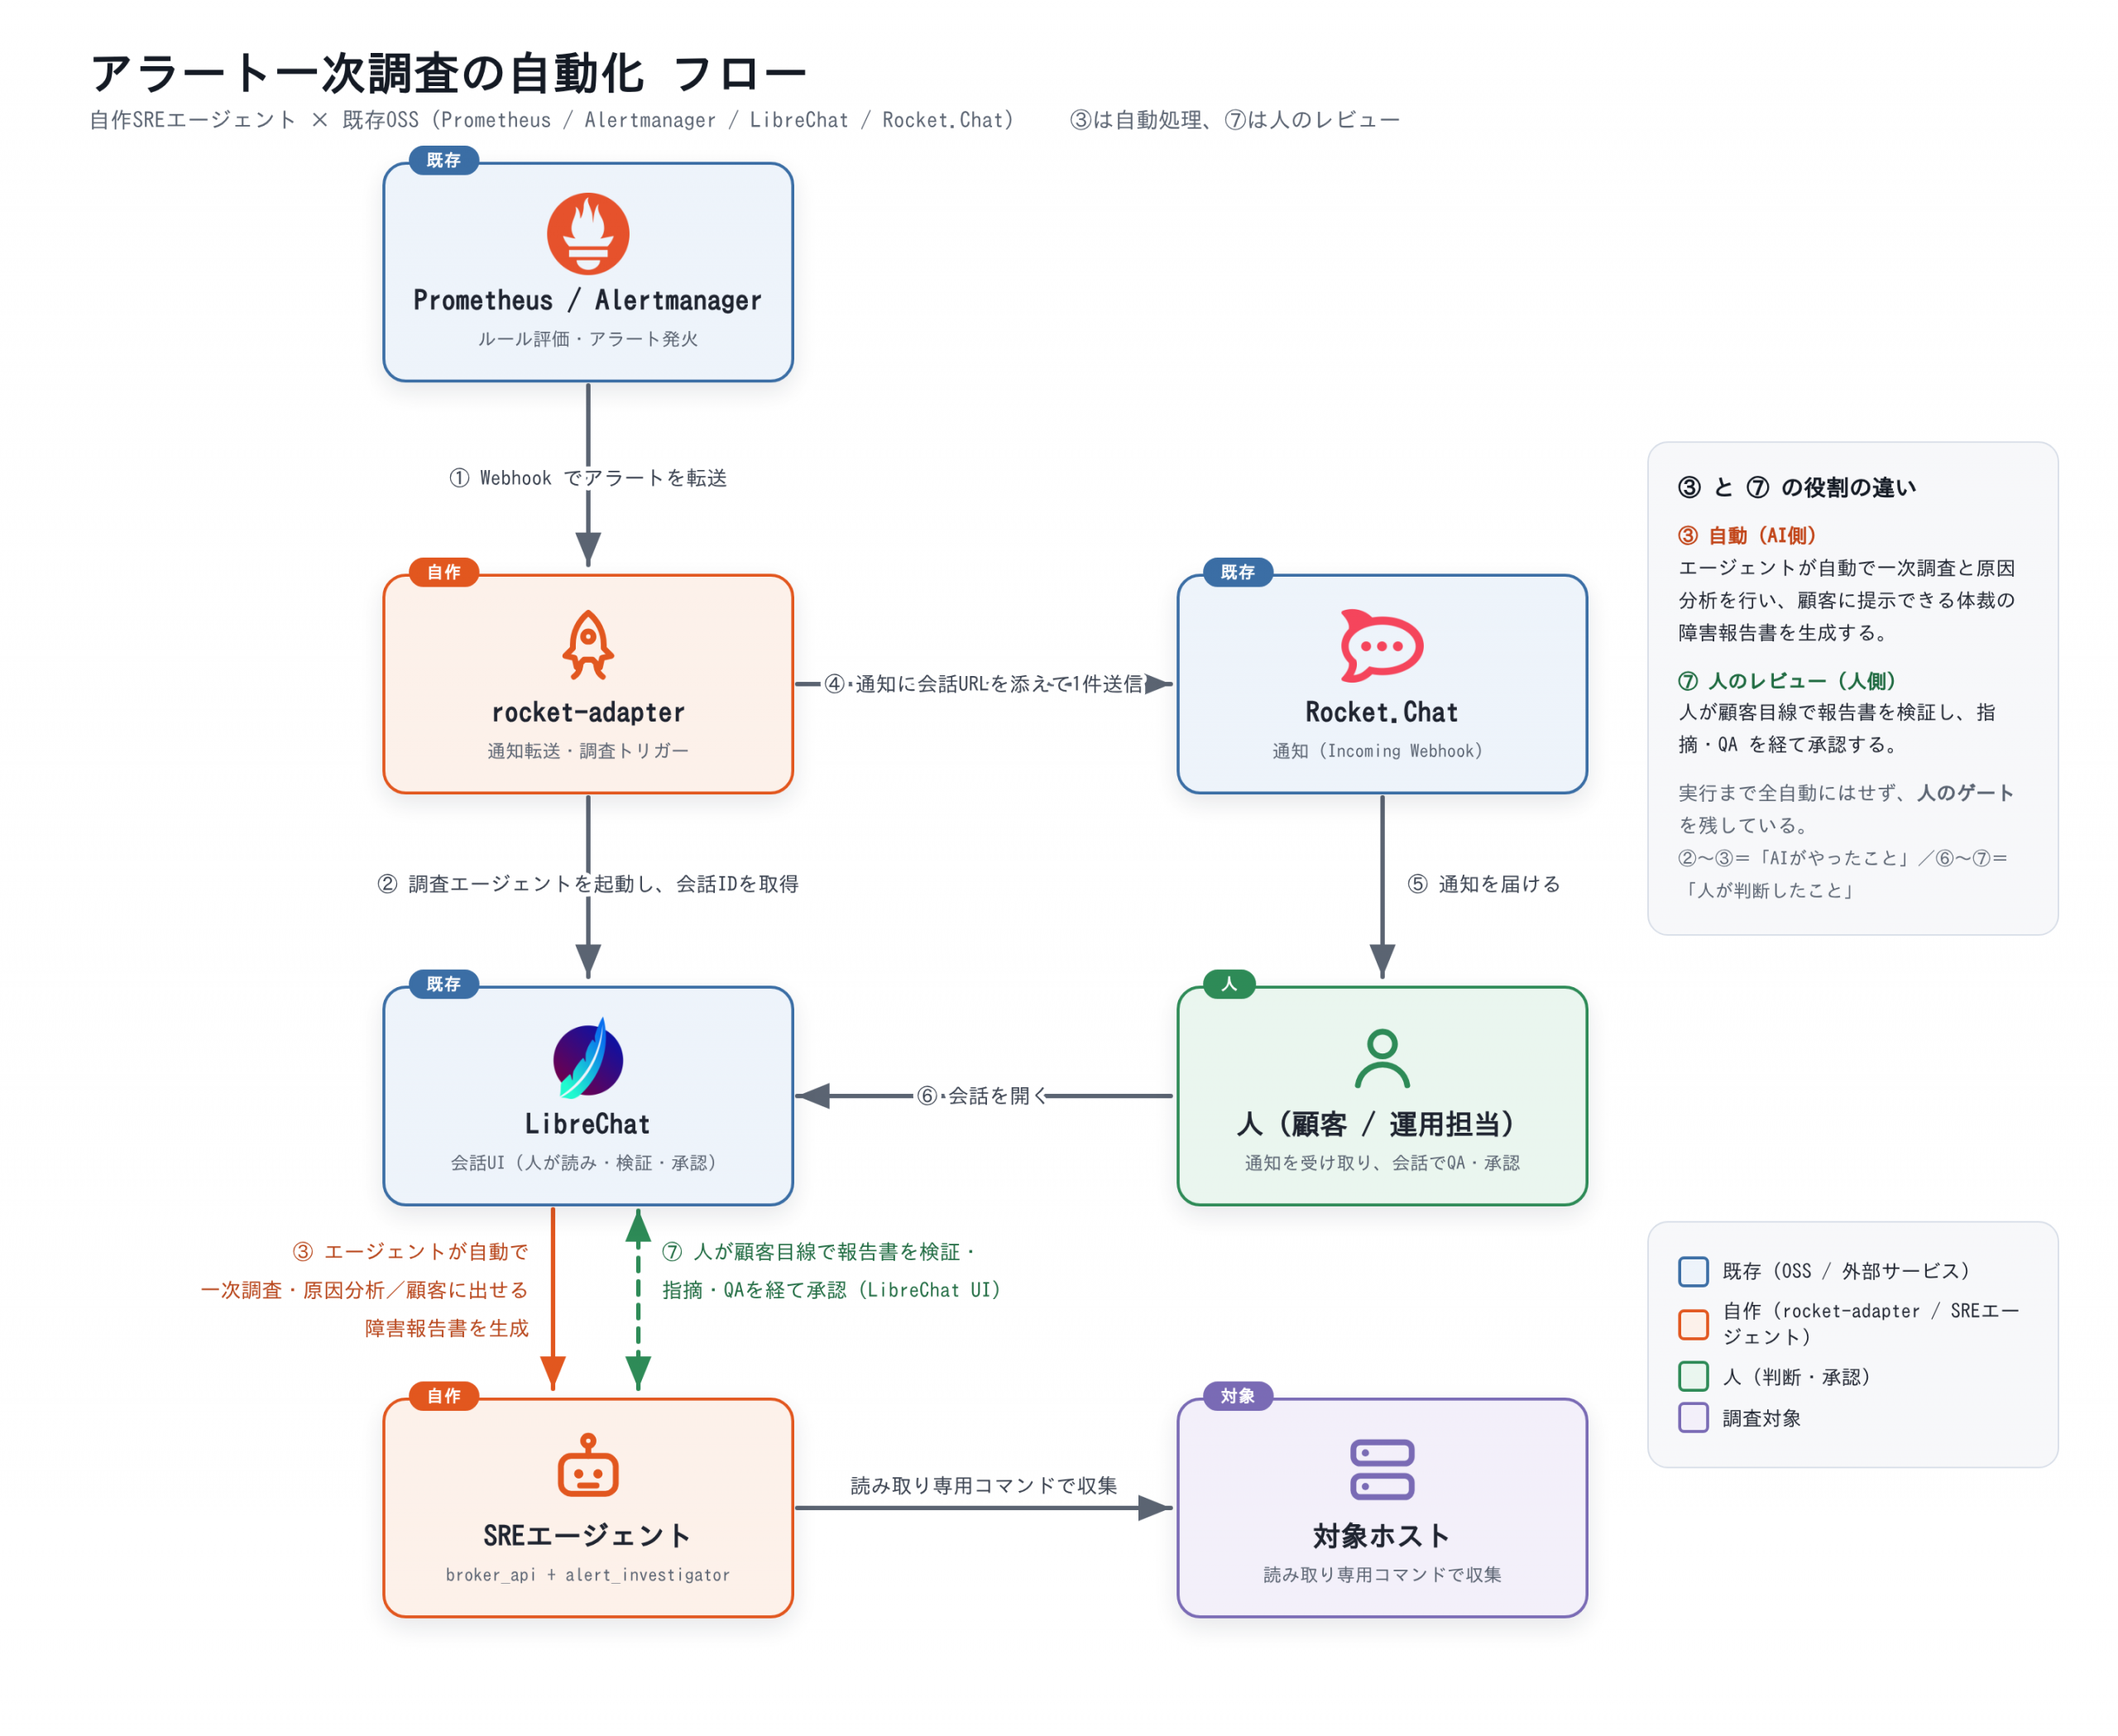
処理の順序を時系列で整理すると、こうなる。
- ①② アラートが発火すると、rocket-adapter が調査エージェントを起動し、会話IDを取得する。
- ③ 起動された会話の中で、エージェントが自動で一次調査と原因分析を行い、顧客に提示できる障害報告書を生成する。
- ④⑤⑥ 通知送信(④)は②の直後に、③と並行して走る。人が通知を受け取り(⑤)、会話を開いたとき(⑥)には、③の報告書ができている。
- ⑦ 最後に、人が顧客の目線で報告書を検証し、指摘・QA を経て承認する。
ここで押さえておきたいのは、③はエージェント側の自動処理、⑦は人(顧客)側のレビューだという役割の違いである。②〜③までが「AIがやったこと」、⑥〜⑦が「人が判断したこと」。この境界を分けておくと、後から経緯を追うときに、どこまでが自動で、どこからが人の判断だったのかがはっきりする。
登場するもの——自作か、既存パッケージか
「AIで何を作ったのか」という話をすると、どこまでが既製品で、どこからが自作なのかが曖昧になりがちなので、先に切り分けておく。
| 役割 | 名称 | 区分 | 実体 |
|---|---|---|---|
| 監視・検知 | Prometheus / Alertmanager | 既存(OSS) | 監視ホスト上の常駐プロセス。ルール評価とアラート発火を担う |
| 通知転送・調査トリガー | rocket-adapter | 自作 | 監視ホスト上の常駐HTTPサーバー。Python の標準ライブラリだけで書いてある |
| 会話UI | LibreChat | 既存(OSS) | 調査結果を人が読み、顧客目線で検証し、承認する場所 |
| 中継・ルーティング | broker_api | 自作 | FastAPI / Starlette / Uvicorn で組んだ中継役。調査依頼を調査エンジンへ振り分ける |
| エージェント実行エンジン | loop_engine / tool_executor | 自作 | ループ制御・ツール実行・状態管理。外部のエージェントフレームワークを使っていない |
| 一次調査エンジン | alert_investigator | 自作 | Python 標準ライブラリ(subprocess による読み取り専用 SSH)。収集→推論→構造化を担う |
| 推論 | LLM API(DeepSeek) | 既存(外部サービス) | httpx 経由で呼ぶ。原因候補と対策案の生成に使う |
| インフラ定義 | Ansible Playbook / 構成台帳 | 自作 | 監視基盤・対象ホスト・通知経路そのものをコードで記述したもの |
| 通知先 | Rocket.Chat | 既存(OSS) | Incoming Webhook で受け取る |
自作なのは、rocket-adapter、SREエージェント(broker_api と alert_investigator、そしてその下で回る実行エンジンをまとめた呼び方)、そしてインフラ定義である。監視も会話UIも通知先も、既存のOSSと外部APIで足りている。自分で書いているのは、それらをつなぎ、自分の環境に合わせて振る舞わせる部分だ。
アラートが鳴ってからFIXするまで
ここからは、ひとつの例で流れを追う。例えば、監視しているホストのCPU使用率が5分平均で90%を超え、その状態が2分続いたとする。 Prometheus のルールがそれを評価し、Alertmanager がアラートを発火させる。ここまでは、よくある監視の話である。問題はこのあと、鳴った瞬間に人がログを追い始める、という部分だった。
① Alertmanager → rocket-adapter
Alertmanager は、あらかじめ設定した Webhook 宛にアラートのペイロードを POST する。これを受け取るのが rocket-adapter である。監視ホスト上に systemd の常駐サービスとして置いてある。
② rocket-adapter → 調査エージェントの起動(会話IDの取得)
ここが今回いちばん効いている部分だ。rocket-adapter は、受け取ったアラートの重要度を見る。critical か warning の「発火」通知であれば、通知を流す前に、LibreChat の会話をトリガーで起動する。事前に発行した長期トークンを付けて、エージェント用のエンドポイントを叩き、返ってきた応答から会話IDを取り出して、その会話のURLを組み立てる。復旧(resolved)通知は対象外にしてある。復旧時に調査を走らせても意味がないからだ。
③ 調査エージェントが自動で一次調査・原因分析を行い、障害報告書を生成(エージェント側の処理)
起動された会話の中で、SREエージェントが動く。処理は三段階ある。
第一段階は収集である。アラートの instance ラベルから対象ホストを解決し、SSH で読み取り専用のコマンドを打つ。ホスト名、稼働時間、ディスク使用量(df)、ディレクトリ別の使用量(du)、100MB超のファイルの探索(find)。instance がホスト名で来る場合は、Ansible のインベントリからアドレスを引いて解決する。
第二段階は推論である。集めたログとアラート情報をプロンプトに詰め、LLMに原因候補と対策案を出させる。このとき「収集した事実だけを根拠にすること」「推測と事実を区別すること」を明示している。
第三段階は構造化である。出力は自由文ではなく、原因候補(cause_candidates)、観測された事実(evidence)、対策案(countermeasures)、想定リスク(risks)に分けたJSONで返す。対策案には、リスクの大きさ、失敗時のロールバック、承認要否を持たせている。人が読む量と、判断の迷いを減らすのが狙いだ。
そして、この三段階の結果が、顧客にそのまま提示できる体裁の障害報告書としてまとまる。原因・根拠・対策・リスク・ロールバックが一枚に揃った状態で、アラート発火から数分で自動的に出来上がる。SREが顧客向けに書く報告書の下書きが、人が何も入力しないうちに用意されている、というのがこの段階の到達点である。
④ rocket-adapter → Rocket.Chat(通知は1件だけ)
rocket-adapter は、元のアラート通知の本文に、先ほど組み立てた会話URLを追記してから Rocket.Chat へ送る。通知は1件だけである。調査が別の通知として飛ぶことも、調査結果が二重に届くこともない。従来のアラート通知と、その調査の会話URLが、ひとつのメッセージにまとまっている。トリガーが失敗した場合でも通知は落とさず、URLなしでそのまま転送する。アラートの通知自体が調査の失敗に巻き込まれて消えるのが、いちばん困るからだ。
⑤ 通知が人に届く
Rocket.Chat に届いた通知を、人が見る。メッセージは1件で、そこには元のアラート内容と、その調査の会話URLが並んでいる。アラートの通知と調査の通知が別々に飛んでくる、という状態にはしていない。
⑥ 人が通知から会話へ入る
通知を見た人が、本文のURLを開く。開いた先は、その調査がそのまま続いている会話である。ログを探し直す必要も、状況を説明し直す必要もない。これが「通知で終わらせず、会話へ着地させる」ということの意味である。
⑦ 顧客目線での検証・指摘・QA・承認(人側の処理)
③で自動生成された障害報告書は、その会話の中に並ぶ。ここからは人の番だ。顧客の目線で、原因の見立てが自分の環境の実感と合っているか、対策案が業務に与える影響はどうか、リスクの記述に抜けはないかを確認する。おかしいと思えばその場で追加調査を指示できるし、説明が粗ければ詰められる。原因の見立てが外れていれば、その場で否定して別の筋を調べさせられる。これは、SREが顧客向けに書いた報告書を、顧客が読んで質疑応答し、納得して承認する、という通常のやり取りを、そのまま会話上で再現している。詰め終わったら、その会話の中でFIXを承認する。会話はそのまま履歴として残るので、「なぜその対処を選んだのか」を後から追える。
③と⑦の違いを、もう一度だけ整理しておく。 ③はエージェントが自動で回す調査と報告書の生成であり、人はまだ何もしていない。⑦は、その成果物を人が顧客の立場で読み、疑い、質問し、納得して承認する工程である。自動で「作る」のが③、人が「認める」のが⑦。この二つを分けて描くことで、自動化の到達点と、人が握り続ける判断が、同じ図の中で混ざらずに済む。
PoC:実際にアラートを起こして確かめた
机上の話では意味がないので、実運用環境でアラートを実際に起こして確かめた。
例えばCPU高負荷なら、対象ホストに意図的に負荷をかけ、監視基盤がそれを検知し、調査エンジンが原因候補と対策案を構造化して返すところまでを実測した。
- 負荷開始からアラート発火まで:約6分半(ルールの継続条件を含む。設計どおり)
- 負荷停止から復旧まで:約50秒
- 調査結果:原因候補3件、対策案3件、各項目に根拠とリスクを付与。受入は PASS
ディスク逼迫のケースでは、最初は「原因ファイルの削除案内」まで到達できずに不合格になった。収集が systemd の失敗ユニットの確認だけで、対象ホストのディスク内訳を見ていなかったのが理由である。ここで収集コマンドを増やし、プロンプトも強化した。調査エンジンの精度は、モデルの賢さより、何を集めて渡すかで決まる。 これが、このときにいちばん強く残った学びである。
その後、本番へ常設化した。調査エンジンをAPI側へ配備し、認証情報は systemd の EnvironmentFile 経由で供給する。監視ホスト側の配備は Ansible の Playbook にまとめて冪等化した。LibreChat 側に調査用のエージェントを用意して結線し、アダプタのトリガー対応版を配備した。配備後は、常駐サービスの稼働、待受ポート、トークンの権限を確認している。
その下にあるもの——なぜ「手足」を持てたのか
ここは、飛ばされやすい。アラート一次調査が自動化できたのは、AIの話ではなく、その下のインフラの話が先に片付いていたからである。 ここを書かないと、「風が吹けば桶屋が儲かる」式に、突然AIが障害を直し始めたように見えてしまう。実際の順序は逆だ。
エージェントに「手足」を与える、というのは、具体的には SSH で読み取り専用コマンドを打てるということにすぎない。だが、打てるだけでは調査にならない。どこに何があって、どのホストが何の役割で、どこにログが出るのかを知らなければ、集める対象を決められない。この「環境の知識」が、事前に用意されていた。
インフラをコードで書いていた。 顧客用のサーバ基盤は Ansible で構築しており、ロールとして役割ごとに分割してある。ミドルウェア、LB、監視、通知、証明書——いずれも Playbook から取り込める形で残してあり、次のサーバを同じ手順で再現できる状態を維持している。エージェントは、そのインベントリをそのまま使って対象ホストを解決する。だから、アラートに載ってくる instance ラベルからホストを引ける。
構成を台帳として文章で持っていた。 構成値は台帳に書いてあり、章ごとに分割してある。エージェントにとっても人間にとっても、「これはどこに書いてあるか」が決まっている状態だ。台帳と実測が食い違えば台帳を直す。この運用を続けていたから、調査エンジンに渡す前提知識が、口伝ではなくファイルとして存在した。
監視も通知経路も、同じ Playbook 群の管理下にあった。 Prometheus、Alertmanager、Grafana、エクスポータ類、そして rocket-adapter の常駐サービス。これらがすべてコードで入り、コードで更新される。だから「監視を足す」「通知の経路を変える」という変更が、AIエージェントの作業対象として扱える。監視が手作業で組まれていたら、ここは毎回職人芸に戻っていたはずだ。
権限は絞ってあった。 調査に使うのは読み取り専用のコマンドだけで、変更系は打てない。認証情報は systemd の EnvironmentFile から供給する。実行まで全自動にしない、という線引き(後述)も、この権限設計と同じ話である。
まとめると、こうなる。インフラをコードで記述し、構成を台帳に書き、監視も通知も同じ管理下に置く。 これを先にやっておくと、AIエージェントに与える「手足」と「環境の知識」が、初めから揃っている。逆に、この層が整っていなければ、どれだけ賢いモデルを繋いでも、エージェントは毎回ゼロからサーバを探り直すことになる。AIの性能ではなく、下の層の整備度が、そのまま初動調査の精度になる。
これは車輪の再発明なのか
正直に書いておく。部品単位で見れば、ほぼ全部が既にある。
アラートをWebhookでチャットへ飛ばすのは定番だし、障害ログをモデルに読ませて原因候補を出させる仕組みも、監視製品や可観測性SaaSがすでに備えている。LLMに手足を与えて運用操作をさせる、という方向も、研究とOSSの両方で数年かけて積み上げられてきた領域である。人が承認してから実行する、というゲートも目新しいものではない。「これは世界初です」とは、私は書かない。 同じことを考え、同じ方向で作っている人は、必ずいる。実際、そういう人は複数いる。
では、どこが自分の形なのか。自分の環境で実際に動いているものから測った数字を置いておく。
| 項目 | 実測値 |
|---|---|
| 運用期間 | 2026-04-29 〜 稼働中(約5ヶ月) |
| 自作Pythonコード | 63,681行 / 372ファイル |
| エージェント実行エンジンの中核 | 2,921行(ループ制御 1,156行 + ツール実行 578行 + 中継 1,187行) |
| 専門エージェント | 10個 |
| インフラ定義(Ansible Playbook) | 514本 |
| コミット数 | 578件 |
この数字を並べたうえで、客観的に言えるのは次の程度である。
- 部品は既存、組み合わせと落としどころが自分の形。 調査結果を通知で終わらせず、そのまま会話が続く場所へ着地させ、通知から同じ会話に入って詰め、合意してから実行へ渡す。しかも調査側の出力形式を、会話の議題にそのまま使える粒度(候補・根拠・対策・リスクの分離)に揃えてある。「調査の出力形式」と「人が詰める場所」を最初から一組で設計している例は、少なくとも私が見てきた範囲では多くない。
- 自動で作る工程(③)と、人が認める工程(⑦)を分けている。 報告書の生成までをエージェントに任せ、その妥当性の判断と承認は人に残す。この線引きを、機能ではなく役割として最初から分けて設計している。
- 通知を増やさないことを設計に入れている。 調査を起こすと通知が2件になる、というのは自動化でよくある失敗である。ここは会話URLを元の通知に混ぜて1件に保つ、という制約を先に決めている。
- 外部のエージェントフレームワークに依存していない。 ループ制御・ツール実行・状態管理は自前で、モデルは差し替え可能な部品として扱う。ロックインを避けるというより、自分の環境に合わせた承認フローと権限を、上から与えられなくて済むようにしたかった。
- そして、5ヶ月間、自分の本番環境で回している。 これは商品の話ではなく、運用の実績である。作って動かして壊して直す、を自分のサーバで続けた分の厚みが、上の数字に出ている。
つまりこういうことだ。「車輪の再発明」の部分はある。そのうえで、既存部品の組み合わせ方と、自分専用のインフラ層を自前で持っている点に、同じ条件の例がそう多くないという意味での先行性がある。 特許の話は、ここでは関係がない。私が知りたかったのは、これが誇張なしにどの位置にあるのかであり、上の数字と、この線引きがその答えである。
なお、承認したあとの実行までを全自動でつなぐことは、あえてしていない。アラートは症状であって原因ではないし、原因候補は候補でしかない。誤検知が本番操作に直結する経路は作らない、という線を引いた。承認状態の管理と、承認後のデプロイ実行は今後の作業である。
既存の監視製品と何が違うのか
既製品を入れれば済む、という問いには、こう答えることになる。
既製の監視製品は「検知」と「可視化」に強い。そこは素直に使うべきで、実際この構成でも、検知は Prometheus と Alertmanager にそのまま任せている。自作したのは、検知と人間のあいだにある「一次調査」と「詰める場所」を連結する層である。ここは製品の当てはめが難しく、自分の環境の語彙(ホスト名、ロール、台帳、監視対象)でしか書けない。だから既製品に寄せるのではなく、自分で薄く書いて、壊れたら自分で直せるようにした。
運用して分かったこと
自動で一次調査が出るようになると、人が見るべき対象は「調査結果の妥当性」と「対策を実行するかどうか」に絞られる。アラートのたびにゼロから考える負荷は確実に下がった。一方で、調査結果の粒度、通知の出し方、収集するログの範囲など、運用に乗せてから見えてくる調整点は残っている。通知は流れて消えるが、会話は残る。この性質をどう運用に織り込むかも、これからの課題である。
そして、最初に書いた「何を集めて渡すかで精度が決まる」という学びは、そのまま下の層を整備し続けることが、そのままエージェントを賢くすることを意味していた。エージェントの性能を上げたければ、モデルを替えるより先に、台帳と収集コマンドを見直すほうが効く。この5ヶ月で得た、いちばん実務的な結論である。
まとめ
- 監視の自動化は「検知」で止まりがちだが、時間を食うのはその先の一次調査である。
- 自作したのは、通知転送と調査トリガーを担う rocket-adapter、一次調査を担う SREエージェント(broker_api と alert_investigator、およびその実行エンジン)、そしてインフラ定義そのもの。監視も会話UIも通知先も、既存のOSSと外部APIで足りる。
- ただし、それらが繋がったのは、下の層が先に整っていたからである。インフラをコードで書き、構成を台帳に書き、監視も通知も同じ管理下に置く。これが、AIエージェントに与える「手足」と「環境の知識」になる。
- 検知したら即座に調査を起動し、会話IDを取得する。エージェントが自動で一次調査と原因分析を行い、顧客に提示できる体裁の障害報告書を生成する(③)。
- 従来の通知と会話URLを1件にまとめて送り、人がその会話に入る。最後に顧客目線で報告書を検証し、指摘・QAを経てFIXを承認する(⑦)。実行まで全自動にはせず、人のゲートを残した。
- ③は「作る」、⑦は「認める」。自動と人の役割を分けて描いている。
- 部品は既存で、組み合わせと落としどころが自分の形。5ヶ月間、自分の本番環境で回しているという事実が、その位置づけを支えている。
- PoCで受入を確認してから本番に常設化した。収集項目の設計が、調査の質を決める。
「AIは何を使ってるんですか」と聞かれたら、こう答えることにしている。道具は何でもいい。大事なのは、自分の環境を知っているエージェントを、自分の手で用意することだ。そしてその前に、自分の環境を、エージェントが読める形で書いておくことである。