会計データを、自分の分析軸で使える形にする
会計データを、自分の求める分析軸で分析したい。会計ソフトの画面は月次決算の確認には十分だが、「前年と比べてどうか」「この費用はどこまで膨らんでいるか」と問うたびに画面を開いて回るのは、正直に言って面倒である。売上を部門別に見たい、費用を勘定科目ではなく取引先別に切りたい——そうした分析軸は、会計ソフトが用意した定型の帳票の外側にある。会計データを自分で正規化して手元のデータベースに持てば、集計の軸は自分で決められる。今回はその実装編として、freee API からの取り込み、正規化したテーブルへの格納、そして数字の検証までを書く。

そのために、順番を先に決めていた。可視化ツールより先にデータ層を作る、という順番である。データマートを三層に分けること、金額を整数の最小単位で持つこと、勘定科目は名称ではなくIDで参照すること、会計期間ごとに未確定と確定を持つこと。これは当初、設計のメモにすぎず、動くコードは一本も無かった。
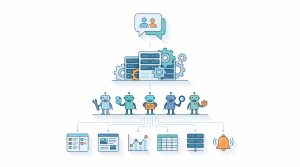
今回はそこから進めて、実際に会計ソフトから数字を取り込み、正規化したテーブルへ落とし、数字の正しさを検証する。動かしてみて初めて見えた細部と、まだ決めきれていない点を、実測した結果と一緒に残しておきたい。この後の話の位置関係は、上の図のとおりである。相手から取り出し、手元の形に整え、正規化した場所へ入れ、数字が合っているかを確かめ、動いたことに気づけるようにする。この順序を崩さないことが、結果としていちばんの近道だった。
結論を急がない理由は次のとおりである。会計データの持ち方は、経営の見方そのものである。売上をどう区切るか、確定と未確定をどう扱うかは、後から気が変わればテーブルごと作り直しになる。だから今は、動くことと、数字の正しさを確かめることを先に固める。見せ方と運用は、後段に回す。
freee API の応答構造を、コードを書く前に実測する
最初にやったのは、コードを書くことではなく、相手の構造を測ることだった。会計ソフトのAPIには、取引を取る入口、試算表を取る入口、勘定科目の一覧を取る入口と、いくつもの呼び出しがある。だが、どの呼び出しがどの粒度で何を返すのか、年度をまたぐと何が起きるのか、といったことは、資料を読んだだけでは確定しない。
そこで探り用のスクリプトを三本書いた。会計期間の一覧を取るもの、レスポンスの項目構造を洗い出すもの、取り込みの下見をするものだ。合わせて235行の、使い捨てのコードである。
この235行は成果物としては残らない。だが、ここで分かったことを前提にしなければ、後続の取り込みコードはすべて推測になる。どの呼び出しが年度単位で、どの呼び出しが期間指定で、どの項目が金額で、どの項目が区分なのか。この切り分けを先に済ませたことで、後段の設計判断が「たぶんこうだろう」ではなく「実測でこうだった」に変わった。
会計データの取り込み単位は、相手の区切りに合わせる
構造を測って、いちばん効いた判断は取得の粒度である。会計ソフトの一括取得には、ひとつの呼び出しで複数月ぶんをまとめて返す原則がある。逆に、月ごとに分割して叩くと、呼び出し回数が増えてレート制限に当たりやすい。
そこで取り込みは、同一年度の中はひとつの呼び出しでまとめて取り、年度をまたぐときだけ年度ごとに分ける、という形にした。年をまたぐ集計は、会計の区切りと暦の区切りが一致しないため、機械的に連続で取ると期間の解釈がずれる。ここは相手の区切りに合わせるのが素直である。
この判断は地味だが、後から効く。月別に分割して叩く設計にしていたら、取得のたびに十数回の呼び出しが発生し、レート制限のリトライ処理が本体に混ざっていたはずだ。呼び出し回数を減らすことは、コードを単純に保つことでもある。
freee API のレート制限と同時接続 — 相手の制約を先に知る
粒度を決めたあと、次に測ったのは相手側の制約である。会計ソフトは、こちら専用のデータベースではない。日中は経理の担当者が画面を開き、帳票を出し、仕訳を直している。その時間帯に大量の呼び出しを投げれば、相手の作業を遅くする。
制約は大きく二つあった。一つは単位時間あたりの呼び出し回数である。短時間に集中させると、一定回数を超えたところで拒否される。もう一つは同時接続である。並列で投げれば速く見えるが、相手の受け入れ能力を超えれば、結局は拒否と再試行の往復になる。
ここから二つの方針が出た。第一に、複数の取得をまとめられるものはまとめる。呼び出し回数そのものを減らすのが、いちばん確実な負荷対策である。第二に、並列度は上げない。速さは目的ではない。目的は、毎日決まった時刻に、正しい数字が入っていることである。
この判断は、アラートの一次調査を自動化した取り組みとは性質が違う。監視は自分たちのサーバが相手で、負荷の限界も自分で調整できる。会計ソフトは相手の道具である。相手の業務時間を避け、呼び出しを控えめにする。この遠慮は、機能の一つとして設計に埋め込んだ。
冪等な取り込み — 同じ取得を何度流しても壊れない
取り込みで最初に決めた原則は、冪等であることだった。同じ取得を二度流しても結果が変わらない。会計データは、失敗して再実行する場面が必ずある。そのとき二重計上が起きる設計は、使えない。
具体は upsert である。会計期間と勘定科目の組をキーにして、存在すれば更新、無ければ挿入とする。貸借対照表のファクトは会計期間×勘定科目×貸借区分をキーにする。取引明細は取引の一意IDをキーにする。キーが決まっていれば、同じデータを何度入れても行数は増えない。

金額は整数の最小単位で持つ。浮動小数は使わない。集計のたびに丸め誤差が乗ることを避けるためだ。通貨は列として持たせ、将来ほかの通貨が混ざっても壊れないようにした。勘定科目は名称ではなくIDを外部キーにし、表示名が変わっても過去の比較が壊れないようにしている。
実装は一気に完成したわけではない。会計ソフトから正規化テーブルへ落とす処理は、書いては直し、直しては書くことを何度も繰り返している。最初から正しいキー設計が出るはずもなく、実データを突き合わせながら削っていった、というのが正直なところである。
失敗しても安全に再実行できるようにする
冪等にしたうえで、失敗時の振る舞いを決めた。
1回の取得は1トランザクションで書く。途中で失敗したらロールバックし、中途半端な状態を残さない。成功した取得は履歴に残す。同じ内容の取得を再実行しても、二重計上にはならない。レート制限に当たった場合は指数バックオフで待つ。待ち時間は回を追うごとに延ばし、相手が落ち着くのを待つ。
再実行は、失敗した取得の単位で行う。全体をやり直すのではなく、失敗した会計期間だけを入れ直す。この粒度を揃えておくと、復旧の手順が「同じコマンドをもう一度」で済む。手順が短いほど、夜中に叩き起こされたときでも間違えない。
正規化した会計データが合っているかを先に確かめる
可視化より先に、数字の正しさを確かめる工程を置いた。会計ソフトの画面に出る試算表と、正規化したテーブルから集計した値を突き合わせるのである。
この検証は、独立したスクリプトとして書いた。売上、費用、利益の主要な科目について、期間ごとに両者を並べ、差があれば落とす。合っていなければ、どんなに見た目が良くても意味がない。検証が通るまではダッシュボードを作らない、という順序を守った。
検証の途中で、貸借対照表の側でつまずいた。損益の側は素直に取れたが、貸借対照表は勘定科目の並びや区分の持ち方が違い、そのままでは意図した集計にならなかった。生のレスポンスを解析するためのスクリプトを別に書き、構造を確認してから取り込みへ反映している。同じ会計データでも、損益と貸借では構造が違う。片方が通ったからといって、もう片方も同じ手順で通るとは限らない。
検証スクリプトは、一度書いたら終わりにしない。取り込みのロジックを直すたびに同じ検証を流す。直したことによって別の科目がずれる、という事故は、この一手間で見つかる。
締め後に数字が動いたら気づけるようにする
検証が通ったら、次は「数字は動く」という前提への備えである。締め前の暫定値は動く。締め後に訂正が入ることもある。動いたことに気づけなければ、いつの数字を見て判断したのかが分からなくなる。
そこで、取得のたびにペイロードのハッシュを履歴へ残すようにした。同じ期間・同じ科目の値が変われば、ハッシュの差分として検知できる。この変更検知は一度書いたあと、検知の対象を調整する修正を入れている。対象を広げすぎると、締め前の通常の変動まで拾ってしまう。どこを「動いた」と見なすかの調整に、いちばん時間を使った記憶がある。
時点情報も明示的に持たせた。ある月の数字が「いつ取得されたものか」を列として残す。締め前の暫定値と締め後の確定値は、同じ期間の同じ科目であっても別の行として区別する。どちらか一方だけを残すと、後から「そのとき何を見ていたか」を再現できなくなる。
会計データの可視化は、損益を先に、貸借は後
可視化の側も、順番を決めて作った。最初に作ったのは損益の概況である。動作を確認してから、貸借対照表の画面を追加した。
損益を先にしたのは、経営の問いがまず売上と利益だからだ。貸借対照表は資産・負債・純資産の状態を見る画面で、損益ほど頻繁には見ない。両方を同時に作ると、確認の手間が二倍になる。片方を確定させてから次へ進むほうが、結果として速い。
未確定の期間は、必ず未確定と分かる見た目にした。この一点は見た目の良さより優先している。数字そのものより、その数字が確定しているかどうかを先に見せる。締め前の数字を確定値と同じ見た目で並べるのは、経営の道具としては危うい。
ETL とは何か — Extract・Transform・Load の意味
ETL とは、データ基盤の分野で数十年にわたり使われてきた一般的な用語である。造語ではない。三つの英単語の頭文字を取ったもので、それぞれ次の意味を持つ。
- Extract(抽出): 元のシステムからデータを取り出すこと。今回の実装では、freee API を呼び、会計期間や試算表のデータを取得する工程がこれにあたる。
- Transform(変換): 取り出したデータを、目的の形に整えること。金額を整数の最小単位に揃え、勘定科目を名称からIDへ置き換え、会計期間をキーとして正規化する作業がこれにあたる。会計データでは、この変換の設計が後々の集計のしやすさを決める。
- Load(書き込み): 整えたデータを、格納先のデータベースへ書き込むこと。今回でいえば、正規化したテーブルへの upsert がこれにあたる。
つまり ETL とは、「取り出して、整えて、入れる」というデータ取り込みの一連の流れを指す言葉である。特定の製品名でも、どこかの会社の造語でもない。データベースを日常的に触る人には馴染みが深い一方で、会計や経理の実務から入ってきた人には、必ずしも当たり前の語ではない。
なお、近年は ELT(Extract・Load・Transform の順)という言い方もされる。先に元のまま格納しておき、必要な変換は格納先の計算資源で行う、という発想である。手元の環境では、金額の丸めや科目IDの解決を格納前に済ませたかったため、変換を先に置く ETL の順を選んだ。呼び方の違いは思想の違いであって、優劣ではない。どちらを選ぶかは、変換をどこで行いたいか、失敗したときにどこまで戻したいかで決まる。
会計データの取り込み自動化(ETL)は最後に置く
取り込みの自動化は最後に回した。ETL を定期実行するための定義を書き、小さな調整を入れて動かしている。日次は当月分を再取得して上書きし、月次は締め後の対象月を確定へ切り替える。
自動化を先に置くと、中身が固まる前にスケジュールだけが動き出す。手で回して数字が合うことを確認してから、定時に置く。順序としてはこれが正しい。
定期実行を入れたあとに見るべきは、実行が成功したかどうかだけではない。取り込みの前後で、数字が意図せず動いていないかである。変更検知を先に作っておいたのは、この確認のためでもある。自動化は、観測の道具を揃えてから入れる。ETL という言葉だけが先に独り歩きすると、動いているように見えて中身が検証されていない、という状態になりやすい。今回そこを避けられたのは、可視化と自動化を最後に回した順序のおかげだと考えている。
データマートに寄せた設計判断と、捨てた案
捨てた案が二つある。

一つは、会話履歴を持つ既存のベクトルデータベースへ相乗りする案である。どのような構成の環境に置こうとしていたかは私のAI環境の見取り図に書いた。会話のベクトルと会計データでは、保持期間も再構築の頻度も参照の特性も違う。同居させれば、片方の再構築がもう片方の可用性に影響する。障害の波及範囲を狭めるという一点で、物理分離を選んだ。面倒を避けるための妥協ではなく、こちらが設計判断である。
もう一つは、監視用のサーバへ会計データを同居させる案である。障害対応の最中に、同じ画面の中に経理の数字がある状態は避けたかった。データソースは追加のみとし、既存の設定は書き換えない。監視系への影響をゼロに保つことを優先した。
つまずいたのは、先にも書いた貸借対照表の構造である。損益と貸借で科目の持ち方が違うことを最初は見落としていた。実データを突き合わせて初めて気づいた。会計の世界は、同じ「勘定科目」という言葉でも、損益計算書と貸借対照表では意味する位置が違う。この違いを、コードを書く前に実測で確認できたことが、結果として手戻りを小さくした。
会計データマートで、まだ決めきれていないこと
この取り組みは、まだ模索の途中にある。どこが固まっていて、どこが固まっていないかを、正直に分けておく。
固まったのは、取り込みの骨格である。相手の構造を実測してから書くこと、冪等を最初に決めること、見た目より先に数字の正しさを確かめること。この三つは、次に別のデータを取り込むときも同じ順序で使える。手応えがある。
固まっていないのは、締めの運用との結びつきである。未確定と確定の切り替えを、経理の実際の締め作業とどう同期させるかは、まだ机上の設計でしかない。締めのタイミングは人の都合で動く。その揺れをどこまで吸収するかは、動かしながら決めるしかないと考えている。
もう一つ、複数年度をまたいだ比較の整合も残っている。年度の区切りと暦の区切りが一致しないため、比較の軸をどちらに置くかで見え方が変わる。経営の判断に使うなら、どちらかに寄せる必要があるが、その選択が何を捨てることになるのかを、まだ言語化できていない。
まとめ — 会計データの正規化で効いた順序
- 着手の前に、相手の応答構造を実測する。探り用のコードは残らなくてよい。
- 取り込みの単位は相手の区切りに合わせる。年度はまとめて、年をまたぐときだけ分ける。
- 相手の制約を先に知る。呼び出しは減らし、並列は上げない。相手の業務を邪魔しない。
- 冪等は最初に決める。キーが決まっていれば、何度流しても壊れない。
- 失敗はトランザクションで巻き戻す。再実行は失敗した単位で行う。
- 見た目より先に、数字の正しさを検証する。
- 締め後に動いたことに気づけるよう、ハッシュと時点情報を持つ。
- 可視化も自動化も、順番を守って最後に置く。
方針を決めることと、動くものを作ることは、別の仕事である。今回いちばん効いたのは、コードを書き始める前に書いた、成果物にならない探りのコードだった。相手を測らずに書いたコードは、あとで必ず測り直しになる。順序を守るという当たり前のことが、この作業でも一番の判断だった。方針を決める時間と、作る時間は、別の日に分けたほうが速い。
ただし、これは完成した設計ではない。取り込みの骨格は固まったが、締めの運用との結びつきと、年度をまたいだ比較の整合は、まだ決めきれていない。次に進むうちに、今回のテーブル設計そのものを直す可能性もある。そのときは、直した理由ごと記録に残したい。
次に確かめたいこと
次は次のあたりを確かめたいと考えている。
- 締めの運用と、未確定・確定の切り替えをどう結びつけるか
- 年度をまたいだ比較を、どう整合させるか
- 経営の問い(売上・利益・資金)に対して、どの画面から入るのが自然か
いずれも、まだ答えは出ていない。次はこのうち一つを取り上げ、今回と同じ形式で、実測と失敗を記録するつもりである。このデータ層の上に、どこまでAIエージェントの土台のような自動化を重ねるかも、あわせて考えたい。